Kenapa Server Down? 5 Penyebab yang Bukan Soal Hardware
Server down tidak selalu berarti hardware rusak. Pelajari 5 penyebab paling umum — dari disk penuh hingga credential expired — dan cara mencegahnya.
Jawaban singkat
Yang perlu dipahami sebelum membaca lebih jauh
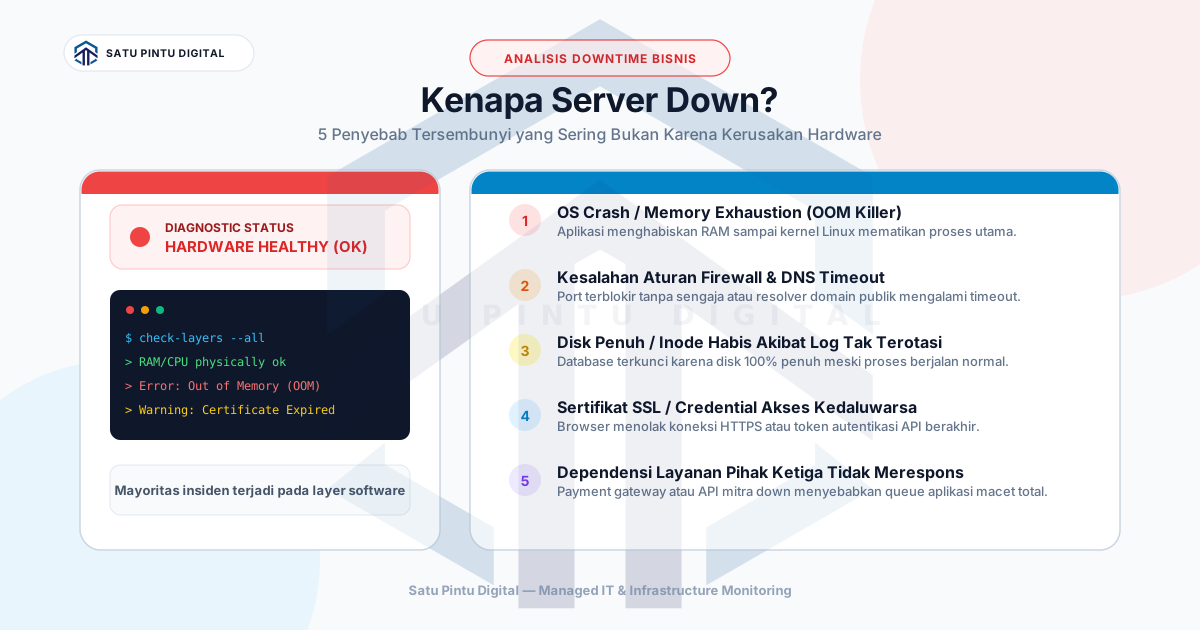
- Server down tidak selalu berarti hardware rusak. Penyebab paling umum justru adalah masalah software (crash, update gagal), konfigurasi jaringan yang salah, disk penuh, credential yang kedaluwarsa, atau dependensi eksternal yang tidak merespons.
Ketika server tiba-tiba tidak bisa diakses, reaksi pertama banyak orang adalah: “Pasti hardware-nya rusak.” Ini adalah asumsi yang wajar — tapi seringkali salah. Dalam praktik pengelolaan infrastruktur sehari-hari, hardware failure adalah salah satu penyebab downtime yang paling jarang terjadi, bukan yang paling sering.
Justru penyebab yang paling sering muncul jauh lebih tidak dramatis: sebuah log file yang tidak dirotasi, sebuah SSL certificate yang expired diam-diam, atau sebuah konfigurasi routing yang berubah setelah update.
Berikut lima penyebab server down yang tidak ada hubungannya dengan hardware — dan cara mencegah masing-masing.
1. OS atau Software Crash
Apa yang Terjadi
Sistem operasi bukan sesuatu yang “pasti selalu stabil”. Kernel Linux bisa mengalami kernel panic — kondisi di mana kernel mendeteksi error fatal dan tidak bisa melanjutkan. Windows Server bisa mengalami blue screen of death (BSOD). Dan bahkan tanpa OS crash sekalipun, OOM (Out of Memory) killer di Linux bisa membunuh proses kritis secara otomatis ketika sistem kehabisan RAM.
Update yang gagal juga masuk kategori ini. Patch OS yang diterapkan tanpa testing — atau dependency software yang berubah setelah update — bisa membuat service tidak bisa start ulang.
Cara Mencegah
- Terapkan patch di staging environment sebelum production
- Gunakan monitoring yang memantau status service kritis (bukan hanya ping ke server)
- Set up memory alerting sebelum OOM killer aktif — misalnya alert ketika RAM usage di atas 85%
- Aktifkan crash dump atau kdump agar ada evidence ketika kernel panic terjadi
2. Network Misconfiguration
Apa yang Terjadi
Server fisiknya mungkin baik-baik saja — nyala, proses berjalan — tapi tidak bisa diakses dari luar karena ada masalah di layer jaringan. Beberapa skenario yang sering terjadi:
- Firewall rules yang terlalu ketat setelah perubahan konfigurasi, memblokir traffic yang seharusnya diizinkan
- Routing table yang salah setelah maintenance atau update network device
- DNS timeout — domain tidak bisa di-resolve ke IP yang benar, padahal IP-nya sendiri masih bisa diping
- BGP atau uplink ISP yang bermasalah di sisi provider
Yang membuat ini berbahaya: dari sisi user, efeknya sama persis dengan server yang mati. Tapi dari sisi server, tidak ada yang salah. Tanpa monitoring network yang tepat, tim akan kehilangan waktu mencari masalah di tempat yang salah.
Cara Mencegah
- Monitoring dari external location (di luar jaringan server) — bukan hanya dari dalam
- Gunakan tools seperti Blackbox Exporter (Prometheus) atau layanan uptime monitoring eksternal
- Dokumentasikan setiap perubahan firewall dan routing dalam change log
- Test konektivitas ke server setelah setiap maintenance window sebelum dinyatakan selesai
3. Disk Penuh atau Inode Habis
Apa yang Terjadi
Ini adalah penyebab downtime yang paling bisa dicegah — dan ironisnya, masih sering terjadi. Ketika disk penuh, banyak hal bisa rusak:
- Database tidak bisa menulis transaksi baru → error atau crash
- Web server tidak bisa menulis access log → service berhenti
- Aplikasi tidak bisa membuat temporary file → gagal memproses request
Tapi ada skenario yang lebih tidak terduga: inode habis. Inode adalah struktur metadata di filesystem Linux yang menyimpan informasi file. Disk bisa masih punya ruang kosong dalam gigabyte, tapi jika inode penuh (karena terlalu banyak file kecil, misalnya dari session PHP atau temporary files), tidak ada file baru yang bisa dibuat. Hasilnya sama: layanan crash.
Penyebab paling umum disk penuh adalah log file yang tidak dirotasi atau backup yang disimpan lokal tanpa batas.
Cara Mencegah
- Set alerting threshold di 75% dan 90% — jangan tunggu 100%
- Konfigurasi logrotate untuk semua aplikasi yang menghasilkan log
- Monitor inode usage secara terpisah dari disk usage (
df -i) - Jangan simpan backup di disk yang sama dengan production data
4. Credential atau Akses yang Expired
Apa yang Terjadi
Banyak sistem modern bergantung pada credential yang punya batas waktu: SSL/TLS certificate, API key, service account token, atau database password yang dirotasi. Ketika salah satu dari ini expired tanpa ada yang tahu, layanan yang bergantung padanya langsung berhenti.
Skenario yang paling sering terjadi:
- SSL certificate expired — browser langsung menolak koneksi, aplikasi HTTPS tidak bisa diakses
- API key pihak ketiga yang dinonaktifkan atau expired karena tidak diperbarui
- Database credential yang berubah setelah rotasi keamanan tapi tidak diupdate di konfigurasi aplikasi
Yang membuat ini licik: server dalam kondisi baik, aplikasinya jalan, tapi fungsionalitasnya tidak bekerja karena satu credential gagal.
Cara Mencegah
- Gunakan monitoring yang memeriksa expired date SSL certificate secara otomatis — alert 30 dan 7 hari sebelum expired
- Inventarisasi semua API key dan service credential dengan tanggal expired-nya di satu tempat
- Saat melakukan rotasi credential, pastikan ada checklist semua titik yang menggunakan credential tersebut
- Implementasikan secret manager (seperti HashiCorp Vault, AWS Secrets Manager) untuk mengelola credential secara terpusat
5. Dependency Eksternal yang Tidak Merespons
Apa yang Terjadi
Aplikasi modern jarang berdiri sendiri. Mereka bergantung pada:
- Database yang mungkin berjalan di server lain
- Message queue (RabbitMQ, Kafka) sebagai middleware
- Third-party API (payment gateway, SMS gateway, layanan autentikasi)
- Microservice lain dalam arsitektur yang sama
Ketika salah satu dependency ini tidak merespons — karena down, timeout, atau ada perubahan API — aplikasi yang bergantung padanya bisa ikut crash atau menjadi tidak fungsional. Dari sisi pengguna, website atau layanan “tidak bisa diakses”, padahal server utama masih jalan.
Ini sering muncul sebagai cascading failure: satu komponen gagal, yang menyebabkan antrian request menumpuk, yang akhirnya membebani komponen lain sampai ikut crash.
Cara Mencegah
- Implementasikan health check endpoint di setiap service yang memuat status dependency-nya
- Gunakan circuit breaker pattern — jika dependency gagal, aplikasi harus bisa degradasi dengan graceful (tampilkan pesan error yang informatif, bukan crash total)
- Monitor latency dan error rate ke setiap dependency eksternal, bukan hanya uptime-nya
- Test skenario dependency down secara berkala — chaos engineering skala kecil
Logging dan Audit Trail: Aset yang Sering Diremehkan
Semua penyebab di atas lebih mudah didiagnosa jika ada logging yang baik. Tanpa log, tim harus menebak. Dengan log yang terstruktur, investigasi bisa dimulai dari data nyata.
Yang perlu diperhatikan:
- Sentralisasi log — jangan biarkan log hanya ada di server yang bermasalah (karena jika server down, log ikut tidak bisa diakses)
- Retention policy — simpan log cukup lama untuk keperluan audit dan investigasi insiden masa lalu
- Structured logging — log dalam format yang bisa di-query (JSON lebih baik dari plain text untuk volume besar)
- Audit trail untuk perubahan konfigurasi — siapa mengubah apa, kapan
Baca juga panduan kami tentang dasar monitoring infrastruktur untuk memahami bagaimana membangun observability yang efektif, dan apa itu managed server jika Anda sedang mempertimbangkan untuk menyerahkan pengelolaan infrastruktur ke penyedia layanan.
Untuk referensi standar industri tentang reliability dan incident response, Google SRE Book adalah bacaan yang sangat direkomendasikan — tersedia gratis online. Dan untuk praktik spesifik di NGINX, panduan production tips dari NGINX cukup praktis sebagai checklist.
Runbook: Supaya Respons Tidak Bergantung pada Satu Orang
Langkah terakhir yang sering diabaikan: dokumentasikan langkah-langkah respons untuk setiap jenis insiden dalam runbook. Runbook bukan dokumen yang panjang dan formal — cukup checklist langkah pertama yang harus dilakukan ketika tipe masalah tertentu muncul.
Tanpa runbook, respons insiden bergantung pada ingatan satu orang. Ketika orang itu sedang cuti atau sakit, semua melambat. Dengan runbook, siapapun yang bertugas bisa mulai dengan langkah yang terstruktur.
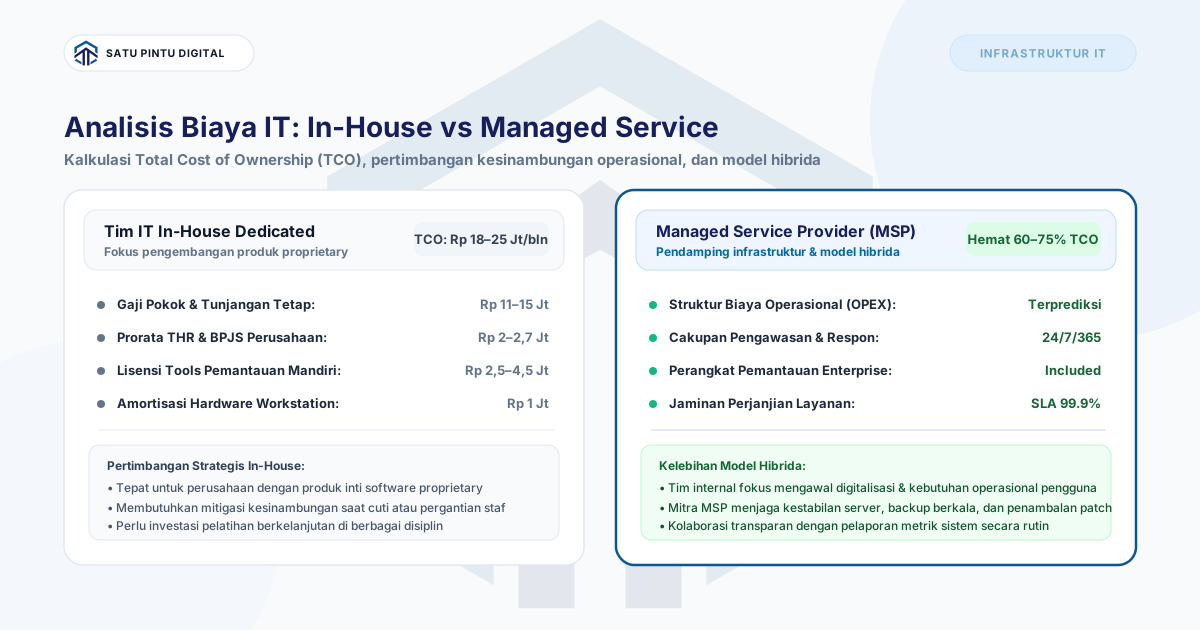
Server Anda butuh monitoring proaktif dan tim yang siap respons sebelum downtime terjadi? Satu Pintu Digital menyediakan layanan Managed Server dan monitoring infrastruktur dengan alerting 24/7, penanganan insiden terstruktur, dan laporan bulanan yang bisa dibaca pemilik bisnis.
Baca sumbernya
Referensi dan dokumentasi
Pertanyaan umum
Yang sering ditanyakan sebelum implementasi
- Berapa lama waktu rata-rata untuk mendiagnosa server down?
- Tanpa monitoring dan logging yang baik, diagnosa bisa memakan waktu 1–4 jam bahkan lebih, karena tim harus menelusuri kemungkinan satu per satu. Dengan monitoring proaktif dan log yang terstruktur, sebagian besar penyebab bisa diidentifikasi dalam 15–30 menit. Itulah mengapa investasi di observability bukan kemewahan — ini adalah efisiensi operasional.
- Apa itu OOM killer dan kenapa bisa menyebabkan server down?
- OOM (Out of Memory) killer adalah mekanisme di Linux kernel yang secara otomatis membunuh proses ketika sistem kehabisan memori. Jika proses yang dibunuh adalah aplikasi kritis (database, web server), layanan akan berhenti tiba-tiba. OOM killer bukan crash — ini proteksi kernel — tapi efeknya dari sisi pengguna sama: layanan tidak bisa diakses.
- Bagaimana cara memastikan SSL certificate tidak expired secara tidak terduga?
- Cara paling andal adalah monitoring otomatis yang memeriksa tanggal expired certificate secara berkala dan mengirim alert 30, 14, dan 7 hari sebelum expired. Beberapa tools seperti Uptime Kuma, Nagios, atau layanan monitoring komersial punya fitur ini built-in. Jangan mengandalkan kalender manual — terlalu mudah terlewat.
- Apa perbedaan antara server down dan aplikasi down?
- Server down berarti mesin atau OS-nya tidak bisa diakses — SSH tidak bisa masuk, semua layanan di mesin tersebut berhenti. Aplikasi down berarti servernya masih jalan, tapi proses aplikasi tertentu crash atau tidak merespons. Keduanya berdampak sama bagi pengguna, tapi pendekatannya berbeda: server down lebih ke infrastruktur, aplikasi down lebih ke layer software.
Umpan balik
Apakah panduan ini membantu memahami arsitektur & keandalan server?
Artikel ini bagian dari catatan digital Satu Pintu Digital. Artikel berikutnya membahas topik yang berkaitan.
Baca berikutnya