Memahami SLA Uptime 99,9%: Standar, Toleransi Downtime, dan Pengukurannya
Panduan lengkap memahami SLA uptime 99,9% vs 99,99%, batas toleransi downtime riil per bulan, klausul kontrak, dan cara mengukurnya secara independen.
Jawaban singkat
Yang perlu dipahami sebelum membaca lebih jauh
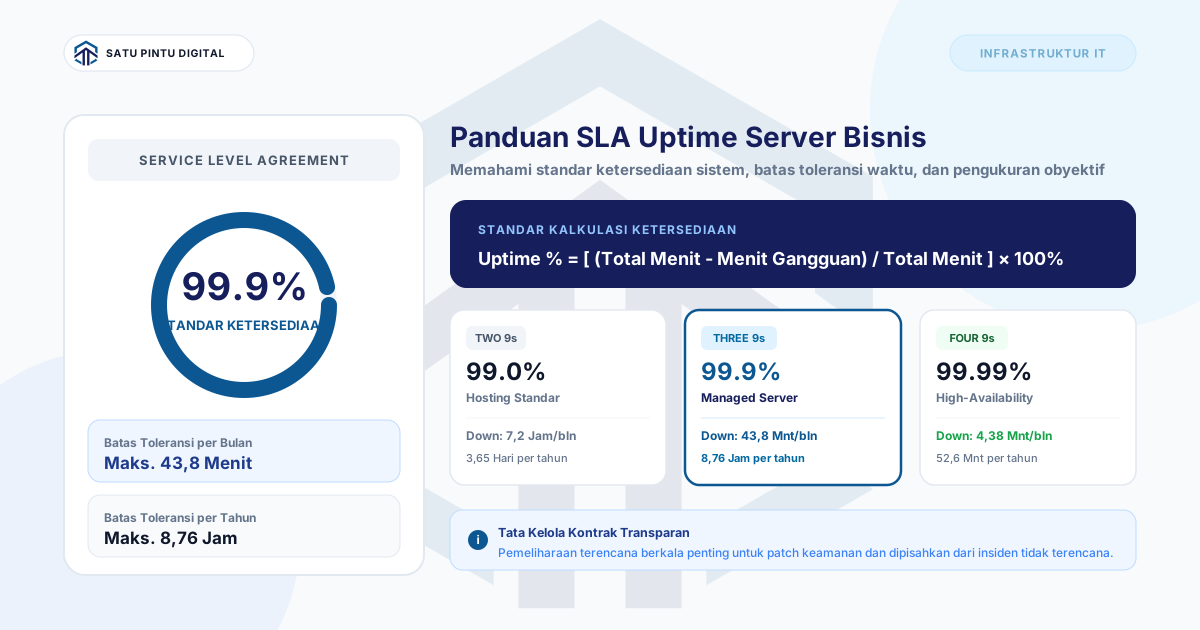
- SLA uptime 99,9% (Three Nines) menetapkan batas toleransi downtime maksimal sebesar 43,8 menit per bulan atau 8,76 jam per tahun. Memahami metrik ini membantu bisnis menyusun ekspektasi operasional yang realistis, merancang strategi kontinuitas data, dan memilih mitra penyedia infrastruktur yang akuntabel.
Bagi para pengambil keputusan di perusahaan—baik direktur operasional, pimpinan divisi keuangan, maupun penanggung jawab teknologi—komitmen Service Level Agreement (SLA) adalah salah satu tolok ukur utama saat memilih infrastruktur server. Pada lembar spesifikasi teknis dan penawaran layanan, angka SLA Uptime 99,9% merupakan standar yang paling umum dicantumkan.
Namun, di balik angka persentase tersebut, terdapat kalkulasi operasional nyata yang berdampak langsung pada ritme bisnis sehari-hari. Memahami apa arti 99,9% secara presisi, bagaimana angka tersebut diterjemahkan ke dalam toleransi waktu, dan langkah-langkah praktis untuk mengukurnya adalah keterampilan mendasar yang membantu bisnis membangun fondasi digital yang tangguh.
Mengapa Angka “9” Begitu Signifikan?
Dalam rekayasa keandalan sistem (Site Reliability Engineering), tingkat ketersediaan layanan (availability) dikelompokkan ke dalam tingkatan yang dikenal dengan istilah “The Nines”. Setiap penambahan angka sembilan di belakang koma menunjukkan lonjakan standar ketahanan sistem yang membutuhkan arsitektur perangkat keras, jaringan, dan prosedur pemeliharaan yang jauh lebih kompleks.
Berikut adalah tabel konversi matematis antara persentase ketersediaan dengan durasi toleransi gangguan (downtime) riil dalam kalender operasional:
| Tingkat SLA | Istilah Industri | Toleransi per Bulan (30 Hari) | Toleransi per Tahun (365 Hari) | Kebutuhan Desain Infrastruktur |
|---|---|---|---|---|
| 99.0% | Two Nines | 7 jam 12 menit | 3 hari 15,6 jam | Server tunggal standar tanpa otomatisasi failover |
| 99.5% | Two Nines Five | 3 jam 36 menit | 1 hari 19,8 jam | Server dengan pemantauan dasar dan backup berkala |
| 99.9% | Three Nines (Standar Industri) | 43,8 menit | 8,76 jam | Infrastruktur cloud/managed server dengan pemantauan proaktif |
| 99.95% | Three Nines Five | 21,9 menit | 4,38 jam | Klaster dengan redundansi jaringan dan catu daya ganda |
| 99.99% | Four Nines (Enterprise HA) | 4,38 menit | 52,6 menit | Arsitektur High Availability (HA) multi-zona otomatis |
| 99.999% | Five Nines (Mission Critical) | 26 detik | 5,26 menit | Sistem kritikal telekomunikasi dan perbankan global |
Bagi sebagian besar aplikasi bisnis komersial—seperti sistem manajemen klinik, portal enterprise, maupun platform transaksi e-commerce—standar 99,9% adalah titik keseimbangan yang ideal antara biaya investasi dan stabilitas operasional. Angka ini menegaskan bahwa sistem dirancang untuk beroperasi dengan toleransi gangguan tak terencana di bawah 44 menit dalam sebulan kalender.
Rumus Baku Perhitungan Persentase Ketersediaan Layanan
Untuk memahami apakah performa server dalam satu siklus penagihan telah memenuhi komitmen yang disepakati, manajemen dapat menggunakan rumus standar yang berlaku di industri komputasi global:
Persentase Uptime (%) = [ (Total Menit Periode - Total Menit Gangguan) / Total Menit Periode ] × 100%Simulasi Perhitungan Operasional:
Misalkan pada bulan dengan 30 hari (total 43.200 menit), sebuah portal transaksi bisnis mengalami kendala jaringan selama 50 menit akibat pembaruan routing upstream:
- Total menit kalender = 30 hari × 24 jam × 60 menit = 43.200 menit.
- Waktu ketersediaan aktual = 43.200 menit - 50 menit = 43.150 menit.
- Nilai ketersediaan riil = (43.150 / 43.200) × 100% = 99,884%.
Dalam simulasi ini, nilai ketersediaan berada sedikit di bawah ambang batas 99,900%. Dengan pencatatan yang terstruktur, tim manajemen memiliki landasan data yang jelas untuk mendiskusikan evaluasi performa bersama mitra pengelola server secara obyektif dan konstruktif.
Memahami Struktur Kontrak: Klausul Operasional Standar
Dokumen SLA yang baik dirancang untuk memberikan kepastian bagi kedua belah pihak. Dalam praktiknya, terdapat beberapa skenario operasional yang secara wajar dikecualikan dari perhitungan gangguan tidak terencana:
1. Pemeliharaan Terencana (Scheduled Maintenance)
Pembaruan rutin—seperti penambalan celah keamanan sistem operasi (security patching), pembaruan kernel, dan inspeksi jaringan fisik—adalah pilar utama pencegahan insiden. Agar tidak mengganggu kenyamanan pengguna, pekerjaan ini biasanya dijadwalkan pada jendela waktu trafik rendah (misalnya pukul 01:00 hingga 04:00 dini hari) dan diinformasikan secara tertulis setidaknya 48 jam sebelumnya. Durasi pemeliharaan yang terencana ini umumnya dipisahkan dari penghitungan downtime insidental.
2. Hambatan Jaringan Publik Eksternal
Jika server dan pusat data beroperasi secara prima, namun pelanggan di wilayah tertentu mengalami kendala akibat putusnya kabel fiber optik operator telekomunikasi lokal atau hambatan resolusi DNS publik, hal tersebut berada di luar batas kendali fisik server penyedia.
3. Kendala Kode Aplikasi Klien
Apabila mesin server berjalan normal namun aplikasi mengalami hambatan akibat galat pemrograman (memory leak atau kueri database yang terkunci), evaluasi penanganan diarahkan pada optimalisasi perangkat lunak. Pemahaman menyeluruh mengenai faktor-faktor ini diulas lebih mendalam dalam artikel kami mengenai faktor non-hardware penyebab gangguan server.
Mekanisme Kompensasi: Praktik Service Credit
Ketika target ketersediaan bulanan tidak terpenuhi karena kendala pada sisi penyedia, mekanisme penyelesaian yang lazim digunakan dalam industri teknologi—sebagaimana diterapkan pada Google Cloud SLA maupun AWS Service Level Agreements—adalah pemberian Service Credit.
Service credit merupakan penyesuaian nilai tagihan pada periode penagihan berikutnya sesuai dengan tingkatan selisih ketersediaan yang terjadi:
- Tingkat Deviasi Ringan (99,0% – 99,89%): Potongan penagihan berkisar antara 10% hingga 15%.
- Tingkat Deviasi Sedang (95,0% – 98,99%): Potongan penagihan berkisar antara 25% hingga 30%.
- Tingkat Deviasi Signifikan (< 95,0%): Penyesuaian tagihan proporsional hingga 50% atau lebih.
Mekanisme ini mencerminkan komitmen akuntabilitas profesional penyedia layanan dalam menjaga keandalan operasional klien.
Tiga Langkah Strategis Mengukur Keandalan Server Secara Obyektif
Untuk memastikan visibilitas operasional yang transparan, perusahaan disarankan menerapkan tiga langkah evaluasi berikut:
- Terapkan Pemantauan Eksternal Independen (Synthetic Monitoring)
Gunakan probe pemantau otomatis yang melakukan pengecekan berkala dari luar jaringan pusat data. Dengan mengamati waktu respons (latency) dan status HTTP setiap 60 detik, perusahaan memiliki catatan historis yang obyektif. Pelajari arsitektur pemantauannya pada panduan dasar monitoring infrastruktur. - Perkuat Ketahanan dengan Prosedur Backup & Disaster Recovery Teruji
Ketersediaan server setinggi apa pun harus selalu diimbangi dengan kesiapan data. Memastikan pencadangan data otomatis tersimpan di lokasi terpisah (off-site) menjamin bahwa bisnis dapat pulih dengan cepat dalam situasi darurat, sebagaimana dijelaskan dalam ulasan strategi backup dan recovery bisnis. - Pilih Mitra yang Menyediakan Laporan Transparan
Kemitraan infrastruktur yang sehat dibangun di atas komunikasi dua arah. Penyedia layanan yang berpengalaman akan menyajikan ringkasan metrik kesehatan server secara berkala, mencakup penggunaan CPU, memori, kapasitas penyimpanan, serta log pemeliharaan keamanan.
Kesimpulan
SLA Uptime 99,9% adalah instrumen tata kelola yang penting dalam memastikan kelancaran operasional digital perusahaan. Angka ini memberikan kepastian target ketersediaan yang terukur, sekaligus menetapkan ekspektasi yang jelas antara manajemen dan tim pengelola sistem.
Bagi organisasi yang ingin memastikan server operasionalnya selalu terpantau dengan standar keandalan tinggi tanpa membebani tim internal, bermitra dengan penyedia layanan profesional adalah langkah strategis untuk menjaga kontinuitas bisnis secara berkelanjutan.
Mencari solusi infrastruktur server bisnis dengan jaminan keandalan dan pemantauan proaktif? PT. Satu Pintu Digital menghadirkan layanan Managed Server dan Monitoring Infrastruktur yang dirancang untuk mendukung operasional perusahaan Anda—lengkap dengan pengawasan 24/7, pemeliharaan patch rutin, dan laporan metrik transparan.
Konsultasikan Kebutuhan Infrastruktur Bisnis Anda Bersama Kami →
Baca sumbernya
Referensi dan dokumentasi
- Google Cloud Service Level Agreements Overview Dokumentasi standar industri Google Cloud mengenai kerangka perhitungan ketersediaan layanan komputasi dan struktur kompensasi
- AWS Service Level Agreements Directory Panduan resmi Amazon Web Services mengenai definisi ketersediaan, pengecualian teknis, dan standar metrik infrastruktur
Pertanyaan umum
Yang sering ditanyakan sebelum implementasi
- Berapa lama batas toleransi server terhenti dalam SLA 99,9% per bulan?
- Dalam satu bulan kalender berdurasi 30 hari (43.200 menit), batas toleransi downtime untuk komitmen 99,9% adalah 43,2 menit. Untuk bulan dengan 31 hari (44.640 menit), toleransinya adalah 44,64 menit. Rata-rata industri yang umum digunakan sebagai acuan adalah 43,8 menit per bulan.
- Mengapa jadwal pemeliharaan rutin (scheduled maintenance) dipisahkan dari perhitungan SLA?
- Pemeliharaan terencana sangat penting untuk memperbarui patch keamanan kernel, firmware, dan keandalan sistem operasi. Standar industri memisahkan pemeliharaan terencana dari insiden tidak terduga, asalkan telah diberitahukan terlebih dahulu dan dilakukan pada jendela waktu beban rendah (off-peak hours).
- Bagaimana cara bisnis memverifikasi ketersediaan server secara obyektif?
- Langkah terbaik adalah menggunakan alat pemantauan pihak ketiga independen (synthetic monitoring) yang mengirimkan permintaan HTTP berkala dari berbagai titik jaringan global, sehingga riwayat ketersediaan tercatat secara transparan dan terukur.
- Apakah SLA uptime menjamin data perusahaan selalu aman saat terjadi gangguan?
- SLA uptime mengukur ketersediaan waktu aktif mesin dan jaringan, bukan pemulihan integritas data internal. Oleh karena itu, komitmen ketersediaan server wajib selalu didukung oleh prosedur pencadangan rutin dan rencana pemulihan bencana (Disaster Recovery).
Umpan balik
Apakah panduan ini membantu memahami Infrastruktur IT?
Artikel ini bagian dari catatan digital Satu Pintu Digital. Artikel berikutnya membahas topik yang berkaitan.
Baca berikutnya